Nvidias Tensor-Bremse wirkt wie eine Preisentscheidung – Linux hat sie offengelegt
Open-Source-Module für Linux verdoppeln den FP16-Tensor-Durchsatz der RTX 4090 ohne zusätzliche Hardware – die Grenze diente offenbar der Segmentierung, nicht dem Silizium.
Foto: ZMASLO / Wikimedia Commons (CC BY 3.0)
Wenn eine Karte bei manchen Operationen nach einem Kernel-Modul und einem Neustart den doppelten Tensor-Durchsatz liefert – war sie dann jemals wirklich durch die Physik „begrenzt“? Das ist die unbequeme Frage, die Nvidia nun beantworten muss, und wir halten die Antwort für offensichtlich.
Was tatsächlich passiert ist
Laut PC Games Hardware umgehen drei Entwicklerprojekte inzwischen die Tensor-Drosselung bei ausgewählten GeForce-RTX-Karten der Serien 20, 30 und 40 unter Linux. Sie bauen auf früheren Arbeiten an Nvidias CMP-Mining-Karten auf. Die Ada-Lovelace-Variante gpu-unlock-ada hebt auf einer RTX 4090 die Begrenzung für FP16- und BF16-Berechnungen mit FP32-Akkumulation auf. Der gemessene Durchsatz steigt von 165,6 auf 331,6 TFLOPS.
Das Ampere-Projekt gpu-unlock ist das ausgereifteste. Auf einer RTX 3090 Ti steigt laut Bericht BF16 von 87,5 auf 157,4 TFLOPS, ein Plus von fast 80 Prozent. Zusätzliche Recheneinheiten oder Speicher werden nicht freigeschaltet. Das Modul läuft vor dem regulären Treiber und nutzt signierte Nvidia-Firmware, anschließend übernimmt der Standardtreiber. Die Änderung verschwindet beim Neustart und muss bei jedem Start erneut angewendet werden.
Die Zahlen sprechen für „Segmentierung“, nicht für „Physik“
Nvidia dokumentiert die Trennung seit Jahren. Im Ada-Lovelace-Whitepaper wird die RTX 4090 laut PCGH mit 165,2 TFLOPS für FP16 mit FP32-Akkumulation und mit 330,3 TFLOPS für FP16 mit FP16-Akkumulation geführt. Das freigeschaltete Ergebnis liegt fast exakt beim zweiten Wert. Derselbe Chip, dasselbe Silizium und eine Obergrenze, die offenbar eine Konfigurationseinstellung ist.
Das sieht nach klassischer Marktsegmentierung aus. Profi- und Rechenzentrumsprodukte auf Basis derselben GPUs erhalten die volle Rate, GeForce-Käufer nicht. Nvidia darf unterschiedliche Produkte zu unterschiedlichen Preisen verkaufen. Aber wir halten es für schwer vertretbar, einen Registerwert als Hardwareunterschied zu bezeichnen. Ein Reddit-Thread formulierte es unverblümt: Die Freischaltung beseitige eine künstliche Beschränkung, damit Unternehmenskunden mehr zahlen müssten. Das ist eine Forenmeinung, keine dokumentierte Tatsache, und Nvidias Motiv wird in den Quellen nicht genannt. Wir können die Daten dennoch kaum anders lesen.
Wir halten auch den Zeitpunkt für wichtig. Die Grenze wirkt sich vor allem bei BF16 aus, das laut PCGH viele aktuelle KI-Modelle verwenden. Nvidia hat diese Karten in einer Welt des Gamings verkauft. Besitzer betreiben darauf nun lokale Sprachmodelle und Bildgenerierung, und unserer Lesart nach trifft eine Drosselung, die KI-orientierte Produkte schützt, auch sie.
Den Gewinn nicht überschätzen und die Risiken nicht ignorieren
Bevor jemand überstürzt etwas flasht, eine kalte Dusche. Die Zuwächse sind ungleichmäßig. PCGH berichtet von den größten Sprüngen bei der Verarbeitung langer Prompts und bei bestimmten Bildmodellen, während die Ausgabe einzelner Token kaum schneller wird. Zuwächse bei den Bildraten in Spielen wurden nicht gemessen. FP8, das Nvidia bei Ada stark beworben hat, verbesserte sich im bisher einzigen Test nur um 0,3 Prozent.
Auch die Belege für die Karte im Mittelpunkt sind dünn. Der Erfolg bei der 4090 wurde auf einer einzelnen Karte nach einem Kaltstart dokumentiert, und laut PCGH ist die Zuverlässigkeit bei anderen Exemplaren nicht ausreichend untersucht. Für Ampere gibt es Nutzerberichte zu nur fünf Modellen, und Turing ist lediglich eine Machbarkeitsstudie. Es handelt sich um experimentelle Software, die unterhalb des Treibers läuft und signierte Firmware mit eigener Nutzlast startet. Wir würden sie wie Übertaktungs-Firmware behandeln: in Ordnung auf einem Ersatzrechner, eine schlechte Idee auf dem Gerät, das man morgen zum Arbeiten braucht. Auf Kulanz bei der Garantie würden wir ebenfalls nicht setzen, wobei die Dokumentation nicht sagt, wie Nvidia reagieren wird, und wir wollen nicht spekulieren.
Unser Urteil
Menschen sollten das Silizium besitzen, für das sie bezahlen. Wenn ein Chip etwas sicher leisten kann, ist es dem Käufer einer Flaggschiffkarte schwer zu vermitteln, es allein zum Schutz eines teureren Modells in der Firmware zu sperren. Dass die Community dafür in die Firmware eintauchen musste, ist die eigentliche Geschichte. Das beste Ergebnis wäre, wenn Nvidia daraus eine offizielle, unterstützte Option machte oder wenigstens erklärte, wo die Grenze verläuft. Wir bezweifeln das, denn der ganze Zweck der Begrenzung scheint die Preistrennung zu sein.
Bis dahin ist unser Rat einfach. Wer unter Linux lokale KI auf einer älteren GeForce betreibt, beobachtet die Reifung dieser Projekte, testet auf nicht kritischer Hardware und wartet auf mehr als eine erfolgreiche 4090. Und wer vor einer Kaufentscheidung steht, sollte bedenken: Datenblätter beschreiben, was der Hersteller dem Chip erlaubt, nicht zwingend, was er leisten kann.
Noch keine Themen: Eröffne das erste.
Weitere Artikel
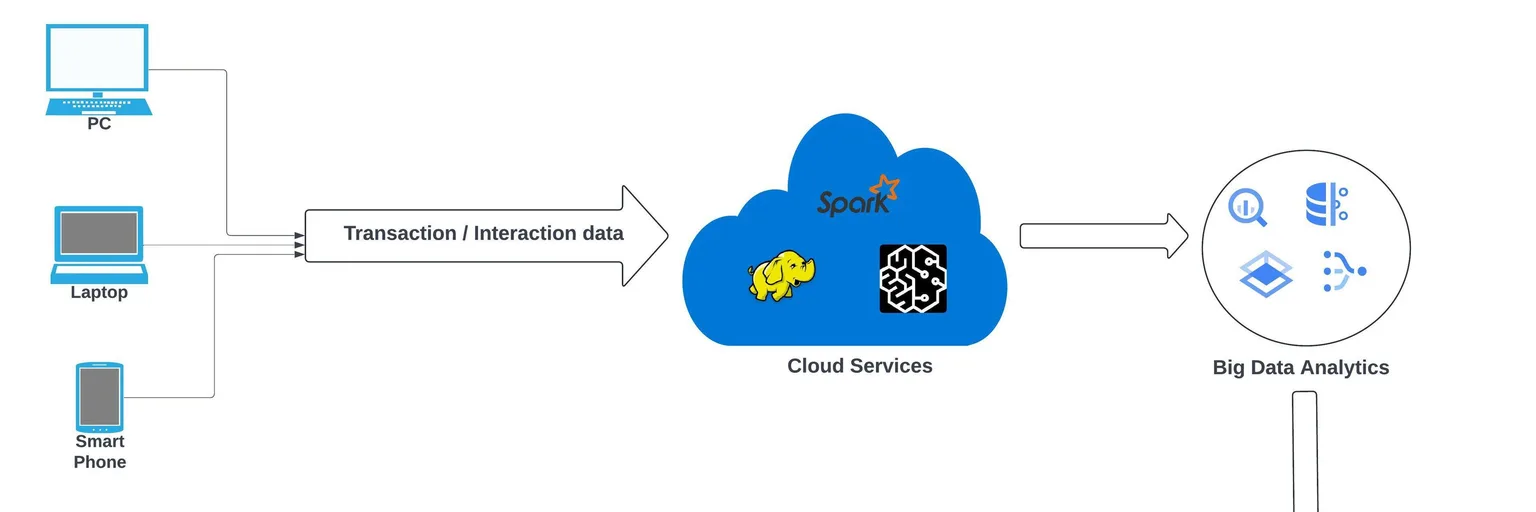
DuckDB 2.0 zeigt, warum Analysen näher an den Daten bleiben sollten
DuckDB 2.0 lehnt die Cloud nicht ab, sondern plädiert dafür, lokale Ausführung, eingebettete Analysen und gezielte Remote-Skalierung in einer Datenarchitektur zu verbinden.
Der erste HPC-Test auf dem Mond prüft vor allem lokale Autonomie
Der Mondcomputer von HPE ist weniger wegen eines Rekords wichtig als als praktischer Versuch: Künftige Missionen müssen lokal rechnen, wenn die Erde zu weit entfernt ist.
NVIDIAs RTX Spark: Windows bekommt endlich seinen KI-Superchip-Moment
Der lang erwartete NVIDIA RTX Spark ist da und fordert Apples Silicon-Vorsprung bei der lokalen Hochleistungs-KI-Verarbeitung auf Windows-PCs direkt heraus.
Das Wettrüsten um die KI-Infrastruktur beschleunigt sich – und die Kosten steigen
Die jüngsten Ankündigungen von Intel, AMD und Nvidia zu Data-Center-GPUs und Server-Racks auf der OCP bestätigen einen sich verschärfenden Wettbewerb um KI-Infrastruktur, der Innovationen, aber auch erhebliche Kostenherausforderungen verspricht.