KI-Datenscraping: Kein Hacking, aber ein rechtliches Minenfeld
Der rasante Fortschritt der KI-Technologie kollidiert mit veralteten Gesetzen zum geistigen Eigentum und offenbart eine kritische Lücke in der globalen Regulierung, die klarere Rahmenbedingungen für Datennutzung und -erstellung erfordert.
KI-generiertes Bild
Handelt ein Unternehmen als „Hacker“, wenn es systematisch öffentlich zugängliche Daten sammelt, um seine Modelle der künstlichen Intelligenz zu trainieren? Diese Frage, die in Tech-Kreisen zunehmend diskutiert wird, ist nicht nur semantisch; sie offenbart ein tiefgreifendes rechtliches und ethisches Vakuum im Herzen unserer digitalen Wirtschaft, das die Gesetze zum geistigen Eigentum nur schwer füllen können.
Der unersättliche Appetit von KI-Modellen auf Trainingsdaten hat zu einem Anstieg des Web-Scrapings geführt, einer Methode zur Sammlung großer Mengen von Informationen aus dem Internet. Diese Daten, die oft urheberrechtlich geschützten Text, Bilder und Code umfassen, sind die Grundlage, auf der generative KI-Systeme ihre Fähigkeiten aufbauen. Doch die Rechtmäßigkeit dieser Praxis ist nach wie vor ungeklärt, was zu einer komplexen Landschaft aus Rechtsstreitigkeiten und neuen Vorschriften führt, die etablierte Vorstellungen von Eigentum und Zustimmung infrage stellen.
Das Urheberrecht-Dilemma: Fair Use vs. Fair Pay
Im Mittelpunkt der Debatte steht die Nutzung von urheberrechtlich geschütztem Material. Generative KI-Modelle werden naturgemäß mit enormen Mengen an Inhalten trainiert, die häufig urheberrechtlich geschützte Werke umfassen, wie academic.oup.com hervorhebt. Die grundlegende Rechtsfrage ist, ob eine solche Nutzung eine Lizenz der Rechteinhaber erfordert oder ob sie als Ausnahme von der Urheberrechtsverletzung, wie etwa Fair Use, betrachtet werden kann. Während das Scrapen von Sachinformationen in der Regel sicherer ist, birgt das Scrapen von expressiven Inhalten ein massives Urheberrechtsrisiko.
Die Rechtslage variiert erheblich zwischen den Gerichtsbarkeiten. In der Europäischen Union bietet die Richtlinie über das Urheberrecht im digitalen Binnenmarkt (CDSM) eine Ausnahme für Text- und Data-Mining (TDM), die die Vervielfältigung und Extraktion von rechtmäßig zugänglichen Inhalten für das KI-Training erlaubt. Rechteinhaber können diese Ausnahme jedoch für kommerzielle TDM-Zwecke ausschließen, was eine Vergütung oder Lizenz erfordert, wenn ihre Inhalte verwendet werden. Darüber hinaus schreibt der EU AI Act nun vor, dass Anbieter von Allzweck-KI-Modellen eine Zusammenfassung der verwendeten urheberrechtlich geschützten Trainingsdaten veröffentlichen und diese Opt-out-Mechanismen einhalten müssen. Dies integriert das Urheberrecht direkt in den Compliance-Rahmen des KI-Gesetzes.
In den Vereinigten Staaten ist die Situation weniger klar. Laufende Rechtsstreitigkeiten, einschließlich Klagen von Zeitungen, Autoren und bildenden Künstlern gegen große KI-Entwickler, testen aktiv die Grenzen der Fair-Use-Anwendung auf das KI-Training. Obwohl US-Gerichte den Trainingsprozess selbst in einigen Kontexten im Allgemeinen als Fair Use behandelt haben, gibt es im Jahr 2025 noch keine endgültige Antwort, was bedeutet, dass die Ergebnisse dieser Fälle die globale Rechtslandschaft maßgeblich prägen werden.
Das Output-Problem: Wem gehören KI-generierte Inhalte?
Die Herausforderungen erstrecken sich über die Trainingsdaten hinaus auf die von KI-Systemen generierten Inhalte. Eine kritische Frage für das Recht des geistigen Eigentums ist, ob KI-generierte Inhalte urheberrechtlich geschützt sein sollten. Sowohl die EU als auch die USA legen derzeit Wert auf menschliche Urheberschaft.
Nach dem EU-Urheberrecht muss ein Werk eine originelle Schöpfung sein, die die eigene geistige Schöpfung des Autors widerspiegelt, um Schutz zu erhalten. Dieser Standard erfordert menschliche Urheberschaft, was bedeutet, dass rein KI-generierte Inhalte ohne nennenswerten menschlichen kreativen Beitrag nicht urheberrechtlich geschützt sind und in den öffentlichen Bereich fallen. Unternehmen, die generative KI kommerziell nutzen, könnten feststellen, dass sie ohne ausreichenden menschlichen kreativen Input kein Urheberrecht an ihren Outputs besitzen, eine Position, die vom EUIPO und nationalen Gerichten konsequent angewandt wird.
Ähnlich prüft das U.S. Copyright Office aktiv die Urheberrechtsfähigkeit von Inhalten, die mit generativer KI erstellt wurden, und hat im Januar 2025 einen Bericht zu diesem Thema veröffentlicht. Dieser Fokus auf menschliche Urheberschaft erstreckt sich auch auf Patente: Das europäische Patentrecht erfordert einen menschlichen Erfinder, und das Europäische Patentamt hat Anmeldungen abgelehnt, die KI-Systeme als Erfinder benennen, was Fragen zur Patentierbarkeit technischer Fortschritte aufwirft, die hauptsächlich von KI ohne menschlichen Input generiert wurden.
Hin zu einer stärkeren Urheberrechtsinfrastruktur
Die Weltorganisation für geistiges Eigentum (WIPO) betont, dass Trainingsdaten für den Erfolg aller aktuellen KI-Systeme von zentraler Bedeutung sind und deren Leistung und Zuverlässigkeit direkt beeinflussen. Der Aufstieg der generativen KI beschleunigt die Notwendigkeit einer starken Urheberrechtsinfrastruktur, um sicherzustellen, dass Kreative fair geschützt werden, während Innovationen gedeihen können. Da urheberrechtlich geschützte Werke zunehmend zum Trainieren von KI-Modellen verwendet werden und KI-generierte Inhalte häufiger werden, wachsen die Herausforderungen in Bezug auf Rechteverwaltung, Zuordnung und Vergütung. Organisationen wie die WIPO und die OECD sammeln aktiv Regierungsinstrumente und veröffentlichen Analysen zu Fragen des geistigen Eigentums in der künstlichen Intelligenz, die mit gescrapten Daten trainiert wird, und erkennen an, dass Datenscraping verschiedene Rechte des geistigen Eigentums betreffen kann, einschließlich Urheberrecht, Datenbankrechte, Marken und Geschäftsgeheimnisse.
Das rechtliche Umfeld rund um KI-Datenscraping und Inhaltserstellung bleibt komplex und entwickelt sich ständig weiter. Das Fehlen eines einheitlichen globalen Ansatzes schafft Unsicherheit sowohl für KI-Entwickler als auch für Rechteinhaber. Während die Technologie ihren rasanten Fortschritt fortsetzt, wird die Notwendigkeit klarerer Vorschriften und einer robusten, länderübergreifenden Urheberrechtsinfrastruktur immer dringlicher, um Innovationen zu fördern, ohne die Rechte der Kreativen zu untergraben.
Noch keine Themen: Eröffne das erste.
Weitere Artikel
Karpathys „KI-Trichter“ zeigt eine gefährliche Spaltung unserer digitalen Zukunft
Andrej Karpathys vierstufiges Modell des KI-Zugangs ist nicht nur eine Beobachtung, sondern eine deutliche Warnung, wer die Spitzentechnologie der künstlichen Intelligenz wirklich versteht, kontrolliert und davon profitiert.
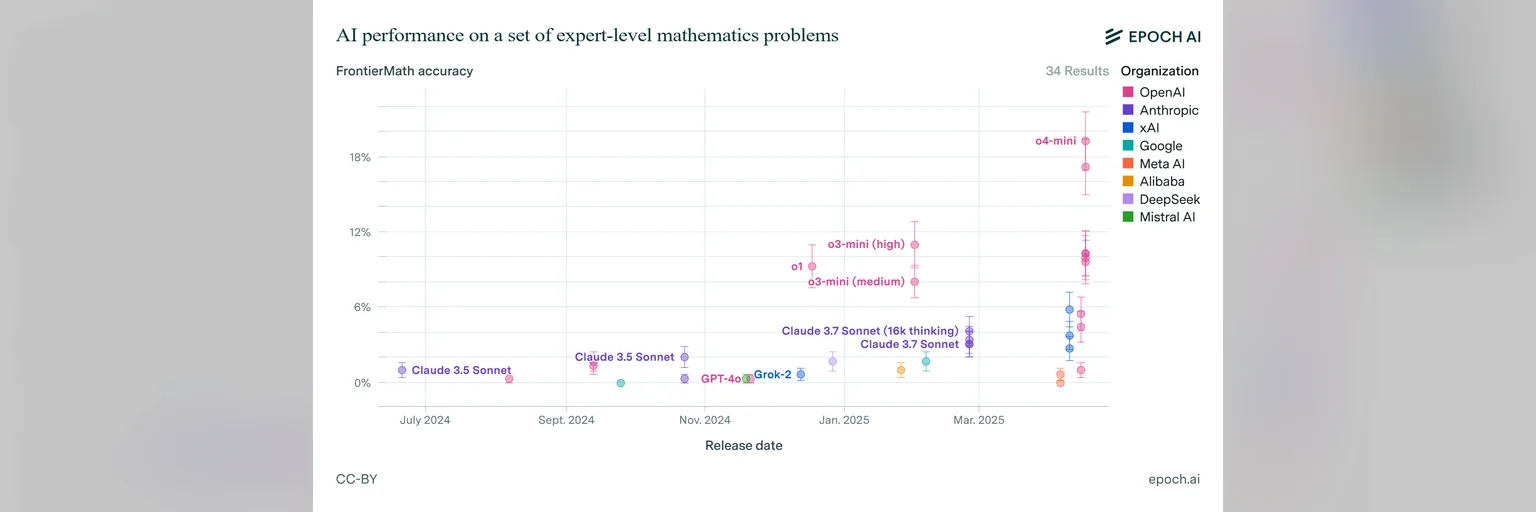
KI in der Mathematik: Krise oder neue Ära der Entdeckungen?
Die jüngsten KI-Durchbrüche in komplexer Mathematik stellen die Gemeinschaft vor eine existentielle Frage: Wird der menschliche Intellekt in den Schatten gestellt, oder läuten diese mächtigen Werkzeuge eine neue Ära der kollaborativen Entdeckung ein?
Amazons 7-Milliarden-Dollar-Spiel: KI-Chip-Agilität sichern
Amazons kolportierte Übernahme von Decart AI für geschätzte 7 Milliarden US-Dollar ist nicht nur eine weitere Akquisition; es ist ein strategisches Manöver, um die zugrunde liegende Infrastruktur der aufstrebenden Künstliche-Intelligenz-Wirtschaft zu kontrollieren, insbesondere hinsichtlich der Interoperabilität von Chips.
Anthropics „Freundlichkeit“-Richtlinie: Schutz oder Paternalismus?
Anthropics neues Verbot „missbräuchlicher und grausamer“ KI-Interaktionen signalisiert eine entscheidende Verschiebung bei der Definition von Mensch-KI-Grenzen, wobei der Fokus stärker auf menschlichem Verhalten als auf KI-Empfindungsfähigkeit liegt.